noindexとは|LPを検索に出さない設定と確認
|広告運用ノウハウ公開中!
より詳しく知りたい方は資料をダウンロード!
広告用に作ったLPが、いつの間にか検索結果に出ていた。反対に、検索からも集客したいページなのに、いつまでたっても検索結果に表示されない。LPを担当していると、こうした「検索に出る・出ない」の問題にぶつかることがあります。
ページを検索結果に出さないための指示が「noindex(ノーインデックス)」です。設定自体はタグを1行入れるだけですが、robots.txtと組み合わせると効かなくなる、広告の審査で使われるクローラーは別の扱いになる、といった落とし穴があります。
この記事では、Googleの公式ドキュメント(2026年10月28日時点の記載)をもとに、noindexの意味と書き方、robots.txtやnofollowとの違い、Google広告のLPとの関係、Search Consoleで設定を確かめる方法をまとめます。
\LPの制作から検証まで、ひとつの画面で/
- ・10日間、有料プランの機能を無料でお試しいただけます
- ・LP制作からA/Bテスト、効果測定までワンストップ
目次
1. noindexとは|ページを検索結果に出さないための指示
1-1. noindexの意味
noindexは、ページやその他のリソースをGoogle検索に表示させないためのルールです。<meta> タグまたはHTTPレスポンスヘッダーで設定し、noindexに対応している検索エンジンに、そのコンテンツをインデックスから除外するよう伝えます。Googlebotがページをクロールしてタグやヘッダーを検出すると、ほかのサイトからリンクされているかどうかにかかわらず、そのページをGoogle検索結果から完全に削除します(出典:noindex を使用してコンテンツをインデックスから除外する|Google 検索セントラル)。
ページ単位で設定できるため、サーバーの設定を変える権限がない場合にも使えます(出典:同上)。LPを作るツールやCMSの画面から設定できることが多いのはこのためです。
1-2. 書き方は「metaタグ」と「HTTPヘッダー」の2つ
noindexの実装方法は、<meta> タグとHTTPレスポンスヘッダーの2つで、効果はどちらも同じです。robots.txtにnoindexを書く方法は、Googleではサポートされていません(出典:noindex を使用してコンテンツをインデックスから除外する)。
| 方法 | 書き方の例 | 向いているもの |
|---|---|---|
| metaタグ(すべての検索エンジン向け) | <meta name="robots" content="noindex"> をページの <head> に入れる | HTMLのページ |
| metaタグ(Googleだけ) | <meta name="googlebot" content="noindex"> | Googleだけに伝えたいとき |
| HTTPレスポンスヘッダー | X-Robots-Tag: noindex をレスポンスに付ける | PDF・動画・画像などHTML以外のファイル |
出典:noindex を使用してコンテンツをインデックスから除外する、Robots meta タグ、data-nosnippet、X-Robots-Tag の指定|Google 検索セントラル
metaタグの name と content は、大文字と小文字を区別しません。また、Google検索はHTMLの <body> にあるrobotsメタタグも尊重するとされています(出典:Robots meta タグ、data-nosnippet、X-Robots-Tag の指定)。なお、検索エンジンによってはnoindexが別の意味に解釈され、ほかの検索エンジンではページが表示され続ける可能性があると書かれています(出典:noindex を使用してコンテンツをインデックスから除外する)。
1-3. noindexと一緒に使われる主なルール
robotsメタタグとX-Robots-Tagには、noindex以外にもルールがあります。カンマ区切りで組み合わせられ、ルールが競合したときは、より制限の厳しいルールが適用されます(出典:Robots meta タグ、data-nosnippet、X-Robots-Tag の指定)。
| ルール | 意味 |
|---|---|
| all | 制限なし(既定値。明示しても何も変わらない) |
| noindex | 検索結果にこのページを表示しない |
| nofollow | このページ上のリンクをたどらない |
| none | noindex, nofollow と同じ |
| nosnippet | 検索結果にテキストのスニペットや動画のプレビューを表示しない |
出典:Robots meta タグ、data-nosnippet、X-Robots-Tag の指定
2. noindexとrobots.txt・nofollowの違い
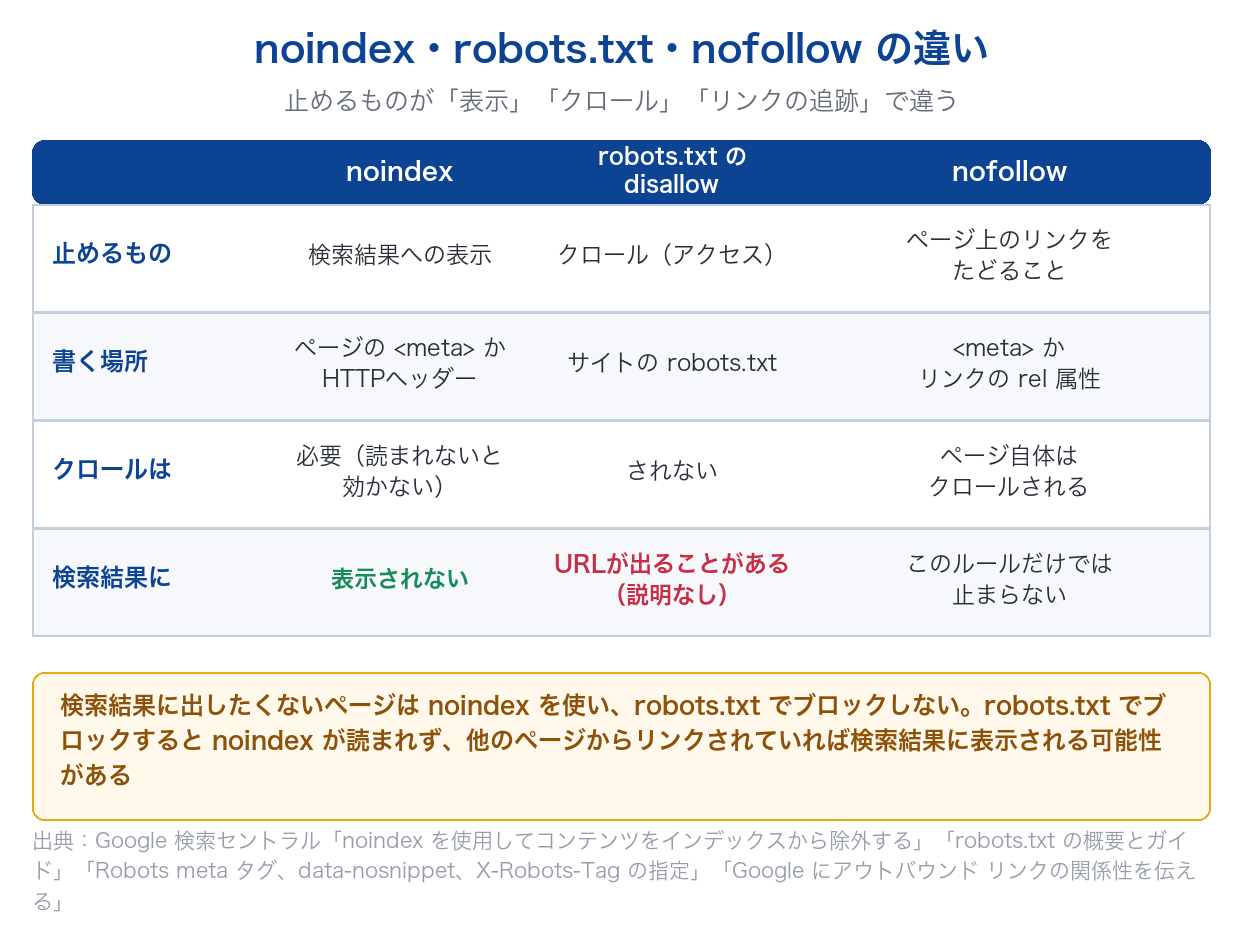
noindex、robots.txt、nofollowは、どれも「検索エンジンに何かをさせない」ための仕組みですが、止めるものが違います。
2-1. robots.txtは「検索結果に出さない」ための仕組みではない
robots.txtは、検索エンジンのクローラーに、サイトのどのURLにアクセスしてよいかを伝えるファイルです。Googleの説明では、主にサイトへのリクエストが多すぎる状態を避けるためのもので、ウェブページをGoogleに表示させないための仕組みではありません。ページを表示させないには、noindexを使うか、パスワードでページを保護します(出典:robots.txt の概要とガイド|Google 検索セントラル)。
robots.txtでブロックしたページでも、ほかのページから参照されていると、GoogleはクロールせずにURLをインデックスに登録することがあります。その場合、検索結果にURLは表示されても、説明は表示されません(出典:同上)。
2-2. robots.txtでブロックするとnoindexが読まれない
noindexを効かせるには、そのページをrobots.txtでブロックせず、クローラーがページにアクセスできる状態にしておく必要があります。robots.txtでブロックされている場合や、クローラーがページにアクセスできない場合、クローラーはnoindexを認識しません(出典:noindex を使用してコンテンツをインデックスから除外する)。
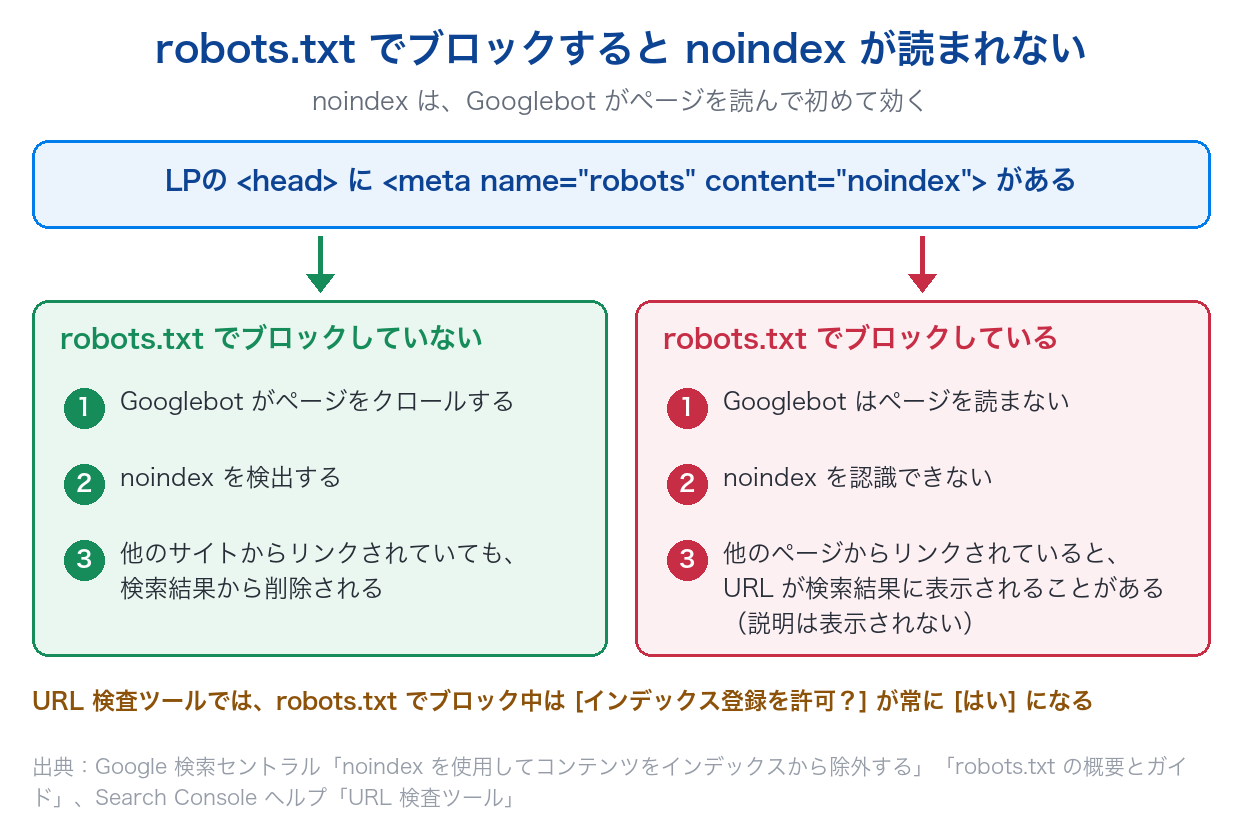
「念のため両方やっておく」と、robots.txtのブロックでnoindexが読まれなくなり、かえって検索結果にURLが残ることがあります。Search Consoleのヘルプも、ページを検索から外したい場合は、robots.txtのブロックを削除してnoindexを使うよう案内しています(出典:ページ インデックス登録レポート|Search Console ヘルプ)。
2-3. nofollowは「リンクをたどらない」ための指示
nofollowは、ページそのものではなく、ページ上のリンクについての指示です。robotsメタタグに書くと「このページ上のリンクをたどらない」という意味になり、<a> タグの rel="nofollow" に書くとそのリンクだけが対象になります(出典:Robots meta タグ、data-nosnippet、X-Robots-Tag の指定、Google にアウトバウンド リンクの関係性を伝える|Google 検索セントラル)。
nofollowが付いたリンクは一般にたどられませんが、リンク先のページは、サイトマップやほかのサイトからのリンクなど別の経路で見つかり、クロールされる可能性があります。Googleは、ページをインデックスに登録させたくない場合は、クロールを許可したうえでnoindexを使うよう案内しています(出典:Google にアウトバウンド リンクの関係性を伝える)。広告の有料リンクには、nofollowより rel="sponsored" が推奨されています(出典:同上)。
3. LPにnoindexを設定するか決める
3-1. 広告からだけ集客するLPを検索結果に出したくないとき
広告の遷移先として作ったLP、訴求を変えて複製したテスト用のLP、フォーム送信後のサンクスページなどは、検索結果に出す必要がないことがあります。検索結果に出したくないページには、noindexを設定します。サンクスページの実装手順の中でnoindexを設定する流れは「サンクスページのデザイン10例|業種別の作り方とCV後の活用法」でも触れています。
ただし、広告用のLPでも、Google広告の審査のためのクローラーはページを読める必要があります。この点は4章で説明します。
3-2. 検索からも集客したいLPはnoindexを外す
商品名やサービス名で検索した人にも見てほしいページは、noindexを外しておく必要があります。LPと会社のホームページでは役割や訪問者の来かたが違うため、どのページを検索結果に出すかは、ページの役割から決めると整理しやすくなります(参考:「LPとホームページの違いは?どちらを作るか判断する基準」)。
Googleのサイト移転のドキュメントでは、開発中にnoindexを使う場合はURLの一覧を作っておき、公開(移転)を始めるときにその一覧からnoindexを削除するよう書かれています。移転でよくある誤りとしても「移転にのみ必要なnoindexやrobots.txtによるブロックは必ず削除」が挙がっています(出典:サイトを移転する方法|Google 検索セントラル)。新しいLPを公開するときも、確認用に付けたnoindexが残っていないかを見ておきましょう。
3-3. すでに検索結果に出ているLPを消したいとき
noindexを追加しても、すぐに検索結果から消えるとは限りません。Googleがページを再びクロールしてnoindexを認識する必要があり、ページの重要性によっては、Googlebotが再びアクセスするのが数か月後になる場合があります。URL検査ツールを使うと、再クロールをリクエストできます(出典:noindex を使用してコンテンツをインデックスから除外する)。
急いで検索結果から外したい場合は、Search Consoleの非表示ツールで、所有しているサイトのページを一時的に検索結果からブロックできます。これは検索結果への表示を止めるもので、クロールは止まりません。期間が過ぎると再び表示されうるため、完全に表示させないためにはnoindexなどの方法を併用します(出典:非表示ツールとセーフサーチ レポートツール|Search Console ヘルプ)。
4. Google広告のLPとnoindex|AdsBotのクロールは止めない
4-1. 広告のリンク先はAdsBotがクロールできる必要がある
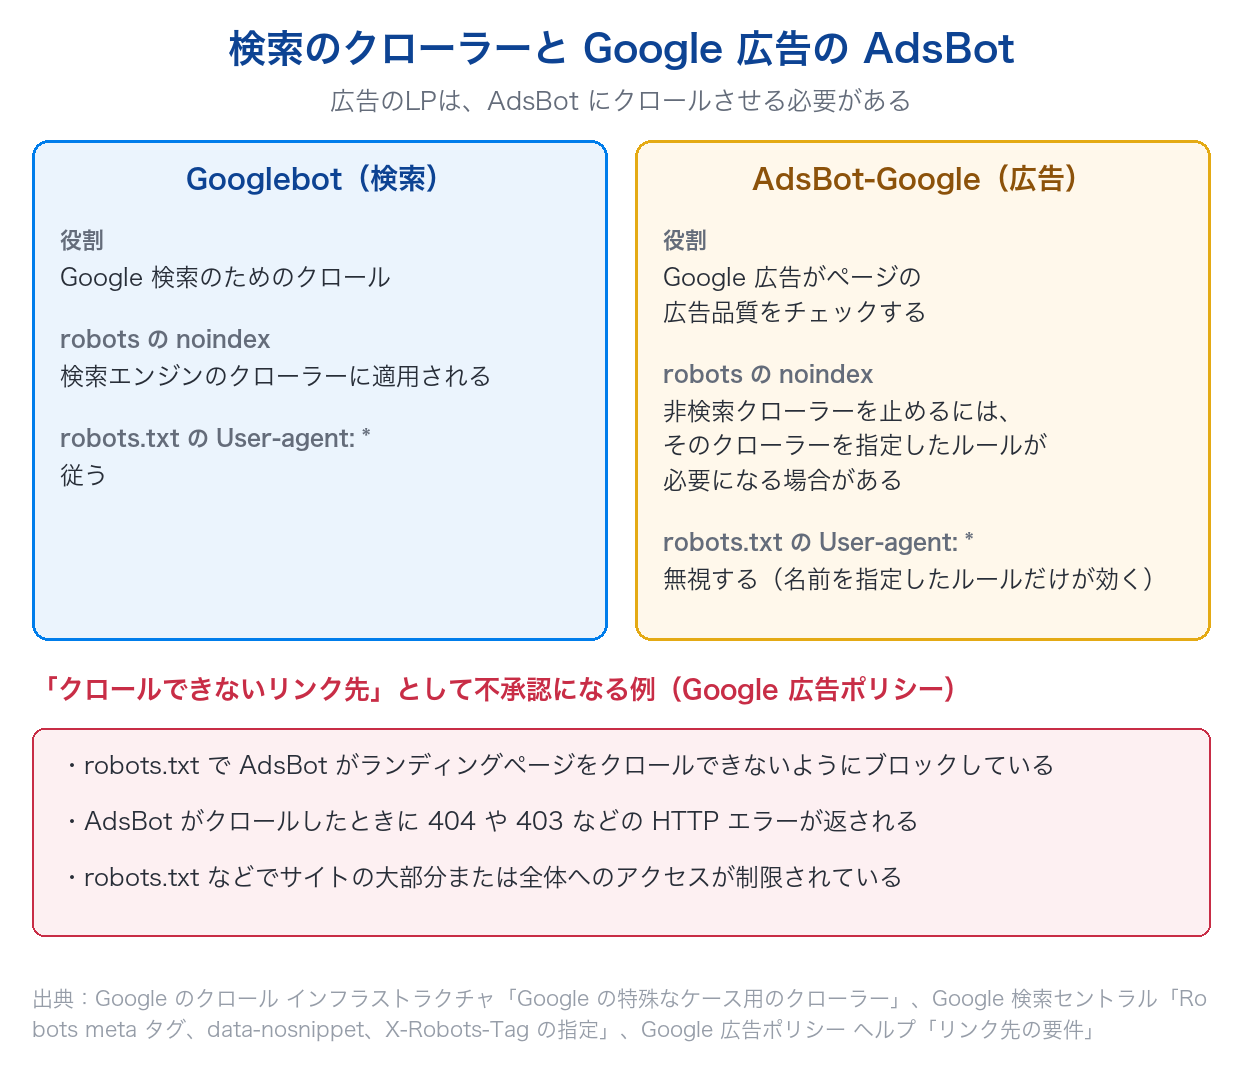
Google広告のポリシーでは、広告のリンク先が広告の内容を反映していることをGoogleが確認できるように、リンク先とコンテンツはGoogle AdsBotウェブクローラーがクロールできる必要があるとされています。robots.txtでAdsBotがランディングページをクロールできないようにブロックしている場合や、AdsBotがクロールしたときに404や403などのHTTPエラーが返される場合は、「クロールできないリンク先」が理由で不承認となります(出典:リンク先の要件|Google 広告ポリシー ヘルプ)。
Google広告の「ランディング ページのテスト」で「ページが見つかりません」と出る場合も、AdsBotによるクロールがブロックされていることが原因の1つに挙がっています。ヘルプは、robots.txtでAdsBotのクロールが許可され、AdsBotにHTTPエラーを返さないことを確認するよう案内しています(出典:ランディング ページをテストする|Google 広告 ヘルプ)。審査で止まる原因全般は「広告審査に通らない原因とは?LP改善のコツとチェックポイント」にまとめています。
4-2. robotsのnoindexは検索のクローラーに向けた指示
Googleのrobotsメタタグの仕様には、<meta name="robots" content="noindex"> は検索エンジンのクローラーに適用されると書かれています。AdsBot-Googleのような検索以外のクローラーを対象にするには、<meta name="AdsBot-Google" content="noindex"> のように特定のクローラーを指定したルールの追加が必要になる場合がある、とされています(出典:Robots meta タグ、data-nosnippet、X-Robots-Tag の指定)。
つまり、LPを検索結果に出さないために入れる通常のnoindex(name="robots")は、検索のクローラーに向けた指示です。広告の審査に使われるAdsBotを止めることが目的ではありません。
4-3. AdsBotはrobots.txtの「User-agent: *」を無視する
robots.txtの扱いも、検索のクローラーとAdsBotでは違います。Googleのクローラーの一覧では、AdsBotは広告主の許可に基づき、robots.txtのグローバルなユーザーエージェント(*)を無視すると書かれています。AdsBotのrobots.txtでのユーザーエージェント名は AdsBot-Google(モバイル向けは AdsBot-Google-Mobile)で、これらのクロール設定は、Google広告がウェブページの広告品質をチェックする機能に影響します(出典:Google の特殊なケース用のクローラー|Google のクロール インフラストラクチャ)。
robots.txtに User-agent: * で書いたブロックはAdsBotには適用されません。一方、一覧には user-agent: AdsBot-Google で始まるrobots.txtのグループの例が載っており、名指しで書いたルールはAdsBotのクロール設定になります(出典:同上)。広告に使うLPのURLを、AdsBotを名指ししてブロックしていないかを確認しておきましょう。
5. noindexが効いているか確認する方法(Search Console)
5-1. URL検査ツールで[インデックス登録を許可?]を見る
Search ConsoleのURL検査ツールでは、ページがインデックス登録を明示的にブロックしているかどうかを[インデックス登録を許可?]で確認できます。ここが[いいえ]なら、ページがnoindexのタグまたはヘッダーを返しているということです(出典:URL 検査ツール|Search Console ヘルプ)。
注意したいのは、robots.txtでページをブロックしている場合です。このとき[インデックス登録を許可?]は常に[はい]になります。Googleがnoindexを確認できないためで、noindexを書いていても検索結果に表示されることがあります(出典:同上)。表示を見るときは、[クロールを許可?]もあわせて確認します。
5-2. 公開URLをテストして、必要ならインデックス登録をリクエストする
インデックスに登録された情報は、最後にクロールされた時点のものです。noindexを付けた・外した直後なら、[公開 URL をテスト]で現在のページをテストします。[クロール済みのページを表示]では、Googleが取得したHTMLやHTTPレスポンスを確認できます(出典:URL 検査ツール)。
noindexを外したページを登録してほしいときは、[インデックス登録をリクエスト]を使います。ヘルプには、インデックス登録は通常1日程度ですむが、長くかかる場合もあると書かれています。リクエストの数とライブテストの実行回数には、1日あたりの上限があります(出典:同上)。
5-3. ページのインデックス登録レポートで一覧を見る
サイト全体でnoindexが付いているページは、ページのインデックス登録レポートで確認できます。noindexが理由で登録されていないページは「URL に noindex が指定されています」に表示され、ヘルプには、登録したくないページなら正しく作動している、登録したいならnoindexを削除する、と書かれています(出典:ページ インデックス登録レポート|Search Console ヘルプ)。
robots.txtのルールやnoindexなど、正当な理由で登録されていないページがあるのは問題ないとされています(出典:同上)。一覧の中に、検索から集客したいLPが混ざっていないかを見るのが確認のポイントです。
6. noindexでよくある失敗例
6-1. 失敗例1:robots.txtでブロックしたLPが、検索結果に残る
症状:検索結果に出したくないLPのURLをrobots.txtでブロックし、ページにもnoindexを入れると、noindexが読まれず、ほかのページからリンクされているLPのURLが説明なしで検索結果に表示され続けることがある。
原因:noindexは、Googlebotがページをクロールして初めて認識されます。robots.txtでブロックされたページはクロールされないため、noindexが読まれません。robots.txtはページを検索結果に出さないための仕組みではなく、ブロックしたページでも、ほかのページから参照されているとURLがインデックスに登録されることがあります(出典:noindex を使用してコンテンツをインデックスから除外する、robots.txt の概要とガイド)。
対策:robots.txtから、そのLPをブロックしている行を削除し、noindexだけを残します。URL検査ツールで[クロールを許可?]が許可になり、[インデックス登録を許可?]が[いいえ]になったことを確認します。
回避策:「検索結果に出さない」はnoindex、「クロールの量を管理する」はrobots.txt、と目的を分けて使います。LPを非公開にする手順書を作るときは、robots.txtを触る手順を入れないようにしておくと、同じ組み合わせを防げます。
6-2. 失敗例2:AdsBotを名指しでブロックし、広告が不承認になる
症状:LPを検索のクローラーから隠すつもりで、robots.txtに AdsBot-Google も含めてブロックのルールを書くと、Google広告の広告が「クロールできないリンク先」で不承認になる。
原因:Google広告のポリシーでは、広告のリンク先はAdsBotがクロールできる必要があり、robots.txtでAdsBotがランディングページをクロールできないようにブロックしていると不承認になります。AdsBotは User-agent: * のルールは無視しますが、AdsBot-Google を名指ししたルールはAdsBotのクロール設定になります(出典:リンク先の要件、Google の特殊なケース用のクローラー)。
対策:robots.txtから AdsBot-Google と AdsBot-Google-Mobile を名指ししたブロックを削除し、Google広告の「ランディング ページのテスト」で「ページが見つかりました」になることを確認してから、広告を再審査に出します。
回避策:LPを検索結果に出さない目的なら、robots.txtではなくnoindex(name="robots")を使います。robots.txtを編集するときは、広告で使っているLPのURLが、AdsBotを名指ししたルールの対象に入っていないかを確認する項目を入れておきます。
6-3. 失敗例3:確認用に付けたnoindexを残したまま公開し、検索に出ない
症状:公開前の確認のためにnoindexを付けたテンプレートや複製元からLPを作り、そのまま公開すると、検索から集客したいページがいつまでも検索結果に表示されない。
原因:noindexが付いたページは、Googlebotが検出した時点で検索結果から除外されます。Googleのサイト移転のドキュメントでも、開発中に使ったnoindexを公開時に削除し忘れることが、よくある誤りとして挙がっています(出典:サイトを移転する方法)。LPを作るツールによっては、初期設定でnoindexが付く場合もあります(Squad beyondのbeyondページは初期設定でON。7章)。
対策:noindexを削除したうえで、URL検査ツールの[公開 URL をテスト]でnoindexが検出されないことを確かめ、[インデックス登録をリクエスト]を送ります(出典:ページ インデックス登録レポート)。
回避策:検索から集客するページを公開するときは、公開前のチェック項目に「noindexが外れているか」を入れます。公開後にページのインデックス登録レポートの「URL に noindex が指定されています」を定期的に見る習慣をつけると、外し忘れに気づけます。
7. Squad beyondでnoindexを設定・解除する
7-1. beyondページは初期設定でnoindexがON
Squad beyondで作るLP(beyondページ)は、タグ設定の「noindexを含める」が初期設定でONになっています(出典:beyondページを検索対象の配信ページにする|Squad beyond FAQ)。広告からの集客に使うLPは、設定を変えなければnoindexが付いた状態で公開されます。
7-2. 検索対象にするときはタグ設定でOFFにする
検索結果に表示させたいbeyondページは、Version編集画面の右側にある「タグ設定」を開き、「noindexを含める」のスイッチをOFFにして保存します。グループやフォルダ内のbeyondページをまとめて検索対象にする場合は、「一括タグ設定」で対象のフォルダを選んで「追加」し、「noindexを含める」をOFFにします。FAQには、「タグ設定」と「一括タグ設定」のいずれかがOFFになった場合、noindexの設定が解除されると書かれています(出典:beyondページを検索対象の配信ページにする)。
一括タグ設定では、noindexの設定のほか、計測ツール・ASPのタグやJavaScriptもチーム・グループ・フォルダ単位でまとめて設定できます。一括タグの作成はオーナー権限のみが可能です(出典:一括タグ機能について|Squad beyond FAQ)。一括タグ設定のリリース時の紹介は「複雑なタグ管理にサヨナラ!?ワンタッチでタグを一括設置できるようになりました!」にあります。
7-3. 検索結果の説明文(ディスクリプション)を設置する
検索対象にしたbeyondページには、検索結果に表示される紹介文(ディスクリプション)も設定できます。「タグ設定」で「noindexを含める」をOFFにし、JavaScript headに <meta name="description" content="表示させたい文章"> を貼り付けて保存します。一括タグ設定を使っている場合は、一括タグ内のnoindexもOFFにするよう書かれています(出典:LPの概要(ディスクリプション)を設置する|Squad beyond FAQ)。
検索対象にするページでは、タグ設定と一括タグ設定の両方を確認しておくと、設定の食い違いを防げます。設定を変えたあとは、5章の方法でSearch Consoleから確認しましょう。
\LPの制作から検証まで、ひとつの画面で/
- ・10日間、有料プランの機能を無料でお試しいただけます
- ・LP制作からA/Bテスト、効果測定までワンストップ
8. noindexについてよくある質問
Q. noindexとは何ですか?
noindexは、ページやファイルを検索結果に表示させないためのルールです。ページの <head> に <meta name="robots" content="noindex"> を入れるか、HTTPレスポンスヘッダーに X-Robots-Tag: noindex を付けて設定します。どちらも効果は同じで、PDFや画像などHTML以外のファイルにはヘッダーを使います。Googlebotがページをクロールしてnoindexを検出すると、ほかのサイトからリンクされているかにかかわらず、そのページはGoogle検索結果から削除されます。
Q. noindexとnofollowは何が違いますか?
止めるものが違います。noindexは「このページを検索結果に表示しない」、nofollowは「このページ上のリンク(または、rel属性を付けたそのリンク)をたどらない」という指示です。nofollowを付けても、リンク先のページはサイトマップやほかのサイトからのリンクなど別の経路で見つかり、クロールされる可能性があります。ページを検索結果に出したくない場合は、クロールを許可したうえでnoindexを使うよう、Googleは案内しています。両方を指定する場合は「none」も使えます。
Q. robots.txtでブロックすれば、検索結果に出なくなりますか?
確実ではありません。Googleは、robots.txtはページを検索結果に表示させないための仕組みではないと説明しています。robots.txtでブロックしたページでも、ほかのページから参照されていると、クロールされないままURLがインデックスに登録されることがあり、その場合は説明のないURLが検索結果に表示されます。さらに、robots.txtでブロックするとnoindexも読まれなくなります。検索結果に出したくないページは、robots.txtでブロックせず、noindexを使うのが公式の案内です。
Q. 広告用のLPはnoindexにしたほうがいいですか?
検索結果に出す必要がないLPなら、noindexを付けるという選択肢があります。通常のnoindex(name="robots")は検索エンジンのクローラーに向けた指示で、Googleの仕様では、AdsBotのような検索以外のクローラーを対象にするには、そのクローラーを指定したルールが必要になる場合があるとされています。一方、robots.txtでAdsBotを名指ししてブロックすると「クロールできないリンク先」で不承認になるため、robots.txtは使わないようにしましょう。Squad beyondのbeyondページは、初期設定で「noindexを含める」がONになっているので、広告専用のLPは設定を変えずに配信できます。
Q. noindexを付けたのに、検索結果から消えません。
noindexを追加したあとに、Googleがまだページをクロールしていない可能性があります。ページによっては、Googlebotが再びアクセスするのが数か月後になることがあり、URL検査ツールから再クロールをリクエストできます。また、robots.txtでブロックしているとnoindexが読まれないため、[クロールを許可?]も確認してください。急ぐ場合は、Search Consoleの非表示ツールで一時的に表示を止められます。Squad beyondで作ったページなら、タグ設定と一括タグ設定のどちらで「noindexを含める」がOFFになっていないかも確認しておきましょう。
Q. noindexを外したのに、検索結果に表示されません。
まずURL検査ツールの[公開 URL をテスト]で、現在のページからnoindexが検出されないかを確認します。noindexが残っていなければ、[インデックス登録をリクエスト]を送ります。ヘルプでは、インデックス登録は通常1日程度ですむが長くかかる場合もあり、リクエストには1日あたりの上限があるとされています。Squad beyondのbeyondページは、タグ設定と一括タグ設定の両方でnoindexの状態を確認し、検索結果に表示させる紹介文として、タグ設定のJavaScript headにディスクリプションのmetaタグを設置しておくと、公開の準備がそろいます。
9. まとめ
- noindexは、ページを検索結果に表示させないためのルール。metaタグ(
<meta name="robots" content="noindex">)かHTTPヘッダー(X-Robots-Tag: noindex)で設定し、効果は同じ - robots.txtは検索結果に出さないための仕組みではない。robots.txtでブロックするとnoindexが読まれず、URLが検索結果に残ることがある
- nofollowはリンクをたどらないための指示で、ページを検索結果から外すものではない
- 広告のLPは、Google AdsBotがクロールできる必要がある。AdsBotは
User-agent: *を無視するが、名指しのブロックで「クロールできないリンク先」になる - 設定のあとは、Search ConsoleのURL検査ツールとページのインデックス登録レポートで、noindexが意図どおりかを確認する
LPを検索結果に出すかどうかは、ページの役割で決まります。Squad beyondでは、beyondページが初期設定でnoindexになっており、検索から集客したいページだけをタグ設定や一括タグ設定でOFFにして、ディスクリプションを設置できます。
---
\LPの制作から検証まで、ひとつの画面で/
- ・10日間、有料プランの機能を無料でお試しいただけます
- ・LP制作からA/Bテスト、効果測定までワンストップ
Squad beyondサービス紹介資料はこちらからダウンロード